
FACTOST-V2 / TEMPORAL MODELS
通用时序预训练
如何让预训练模型学习跨领域可迁移的时序模式,同时适应不同长度的历史与预测区间?
我的工作
设计并预训练 UTP,完成跨领域预测评估与组件消融实验。工作时间:2025 年 10 月至 2026 年 1 月。
模型设计与预训练
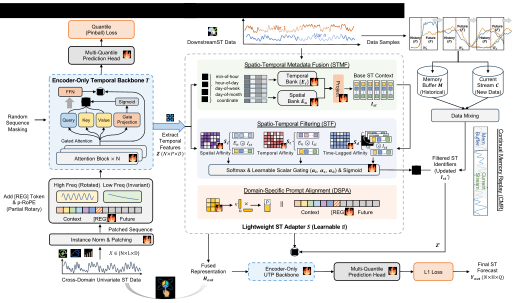
UTP 使用 encoder-only 时序骨干:先对输入序列归一化并切分成不重叠的片段,再随机遮蔽历史前缀,使模型在训练时接触不同长度的有效上下文。预训练配置支持最多 2,048 步输入与 256 步预测。
可学习的 register token 分隔历史上下文与未来占位片段;骨干结合 partial RoPE 与 gated attention,多分位数预测头使用 pinball loss 学习概率预测。这一阶段专注时序模式,完整框架再通过下游空间适配注入领域信息。
如何检验跨领域迁移
我们在未纳入预训练的基准数据集上评估固定权重的零样本预测,覆盖 12→12 与 96→96 的历史/预测长度配置。这样可以直接检验预训练表征对新数据集的迁移表现。
消融:历史前缀遮蔽的作用
PEMS08,历史与预测长度均为 96 步,指标为 MAE(越低越好)。下表使用个人介绍 PPT 与论文表 IX–X 的相同结果。
| 配置 | MAE |
|---|---|
| Full UTP | 91.09 |
| Vanilla RoPE | 91.65 |
| No gated attention | 94.71 |
| No quantile loss | 97.48 |
| No prefix masking | 107.22 |
加入前缀遮蔽后,MAE 从 107.22 降至 91.09,相对降低约 15.0%。反过来看,移除遮蔽相对完整模型的误差增加约 17.7%;两者的计算基准不同。
这项消融验证了该评估设置下遮蔽策略的作用;更广泛的跨领域结论需要结合论文中的完整数据集与实验协议判断。