FactoST-v2
预印本 · 2026
Learning to Factorize and Adapt: A Versatile Approach Toward Universal Spatio-Temporal Foundation Models
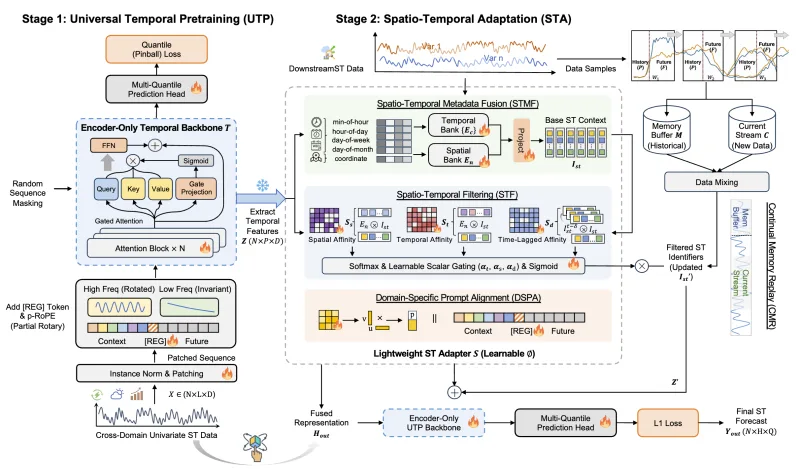
以统一的时序骨干网络支持可变长度上下文和概率预测,并在下游适配中完整复用预训练权重。
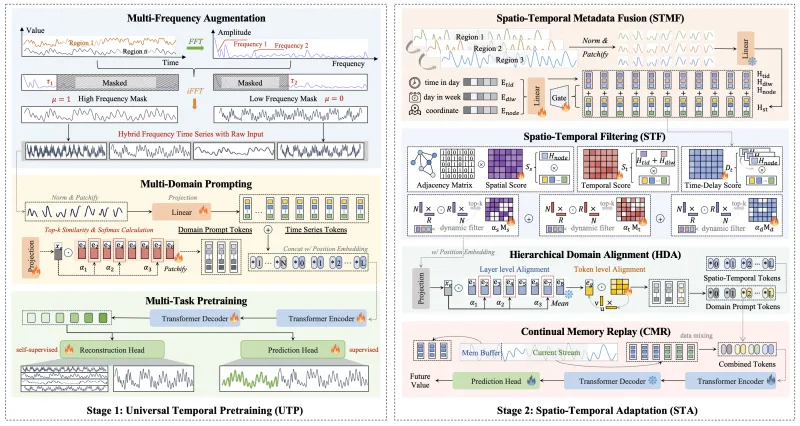
我设计了通用时序预训练(UTP),并完成其预训练、跨领域评估与消融实验。
方法与评估
采用仅编码器的分位数预测模型,对序列进行归一化与分块,随机掩蔽历史前缀,并结合门控注意力与部分旋转位置编码。模型配置最多支持 2,048 步输入与 256 步预测;在未参与预训练的基准上,固定权重零样本评估采用 12→12 与 96→96 的上下文/预测长度。
在 PEMS08 的 96→96 设置下,使用历史掩蔽的模型 MAE 为 91.09,未使用时为 107.22,相对降低约 15%。详见论文表 IX–X。